Dify 是一个开源的 LLM 应用开发平台,提供可视化编排、知识库、工作流、API 服务等能力,让你能快速搭建对话助手、Agent、知识库问答等 AI 应用。
通过 NovaWander AI,你可以在 Dify 中以一套 API Key 调用 100+ 主流模型(Claude、OpenAI、Gemini、Qwen、DeepSeek、Kimi 等),并享受统一计费、故障自动转移、企业级稳定性。
一、快速集成
1. 获取 API 密钥
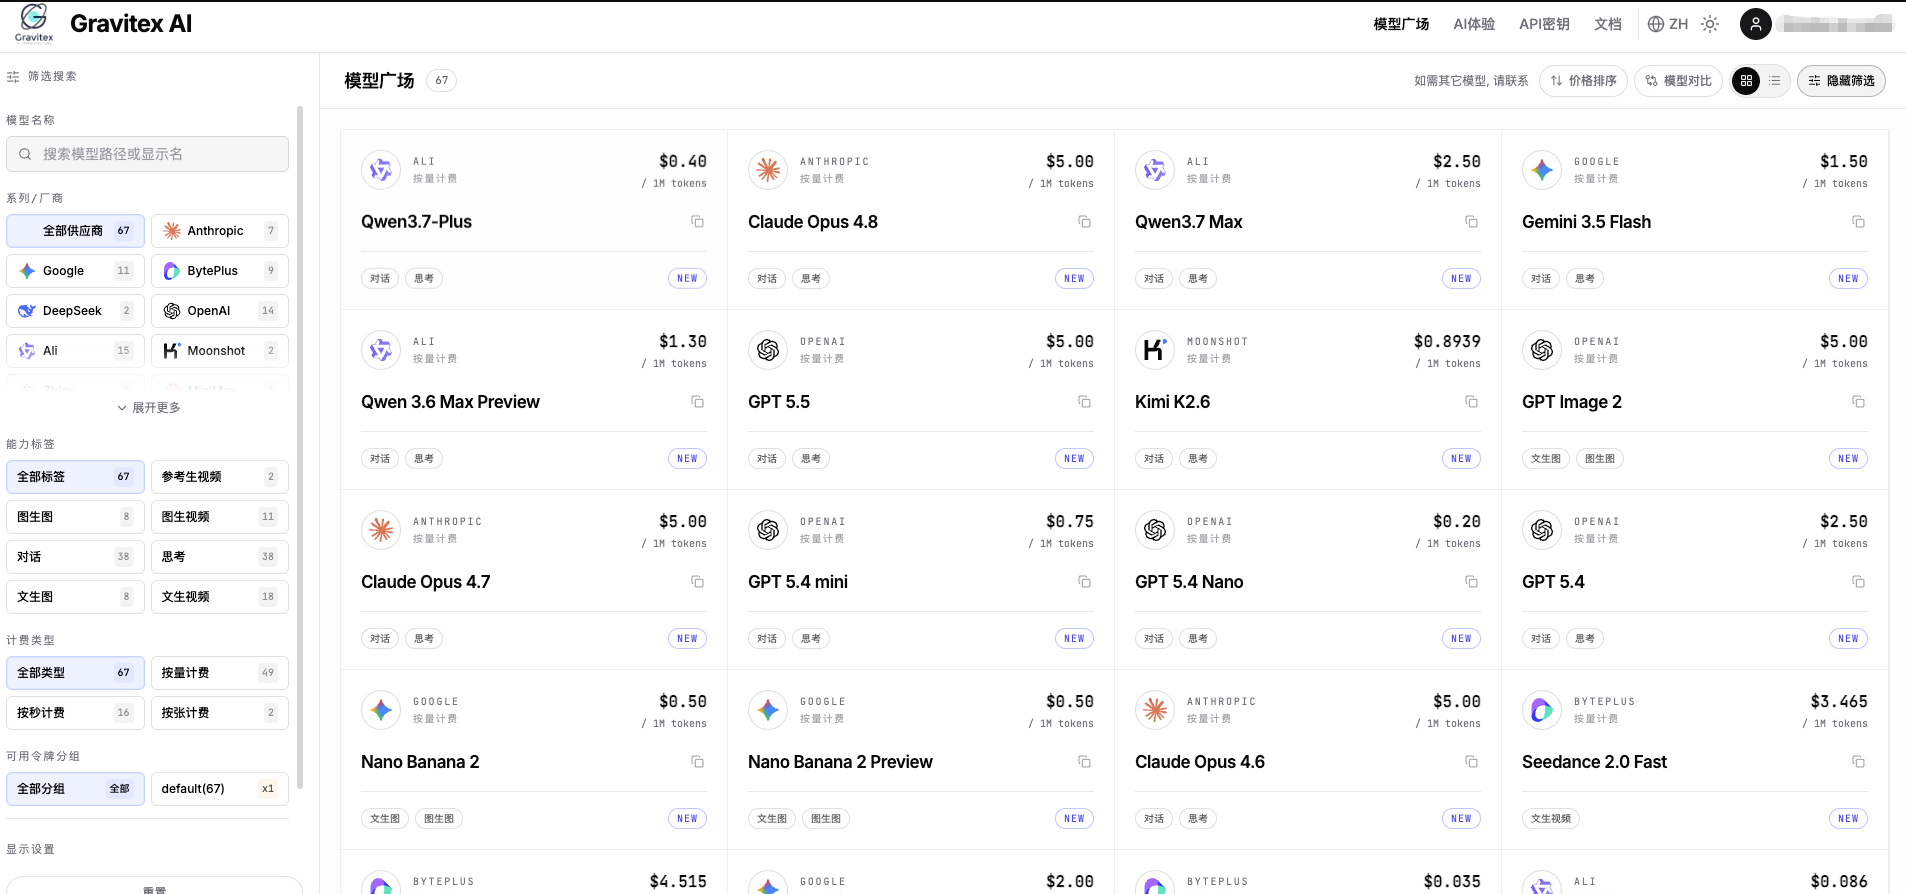
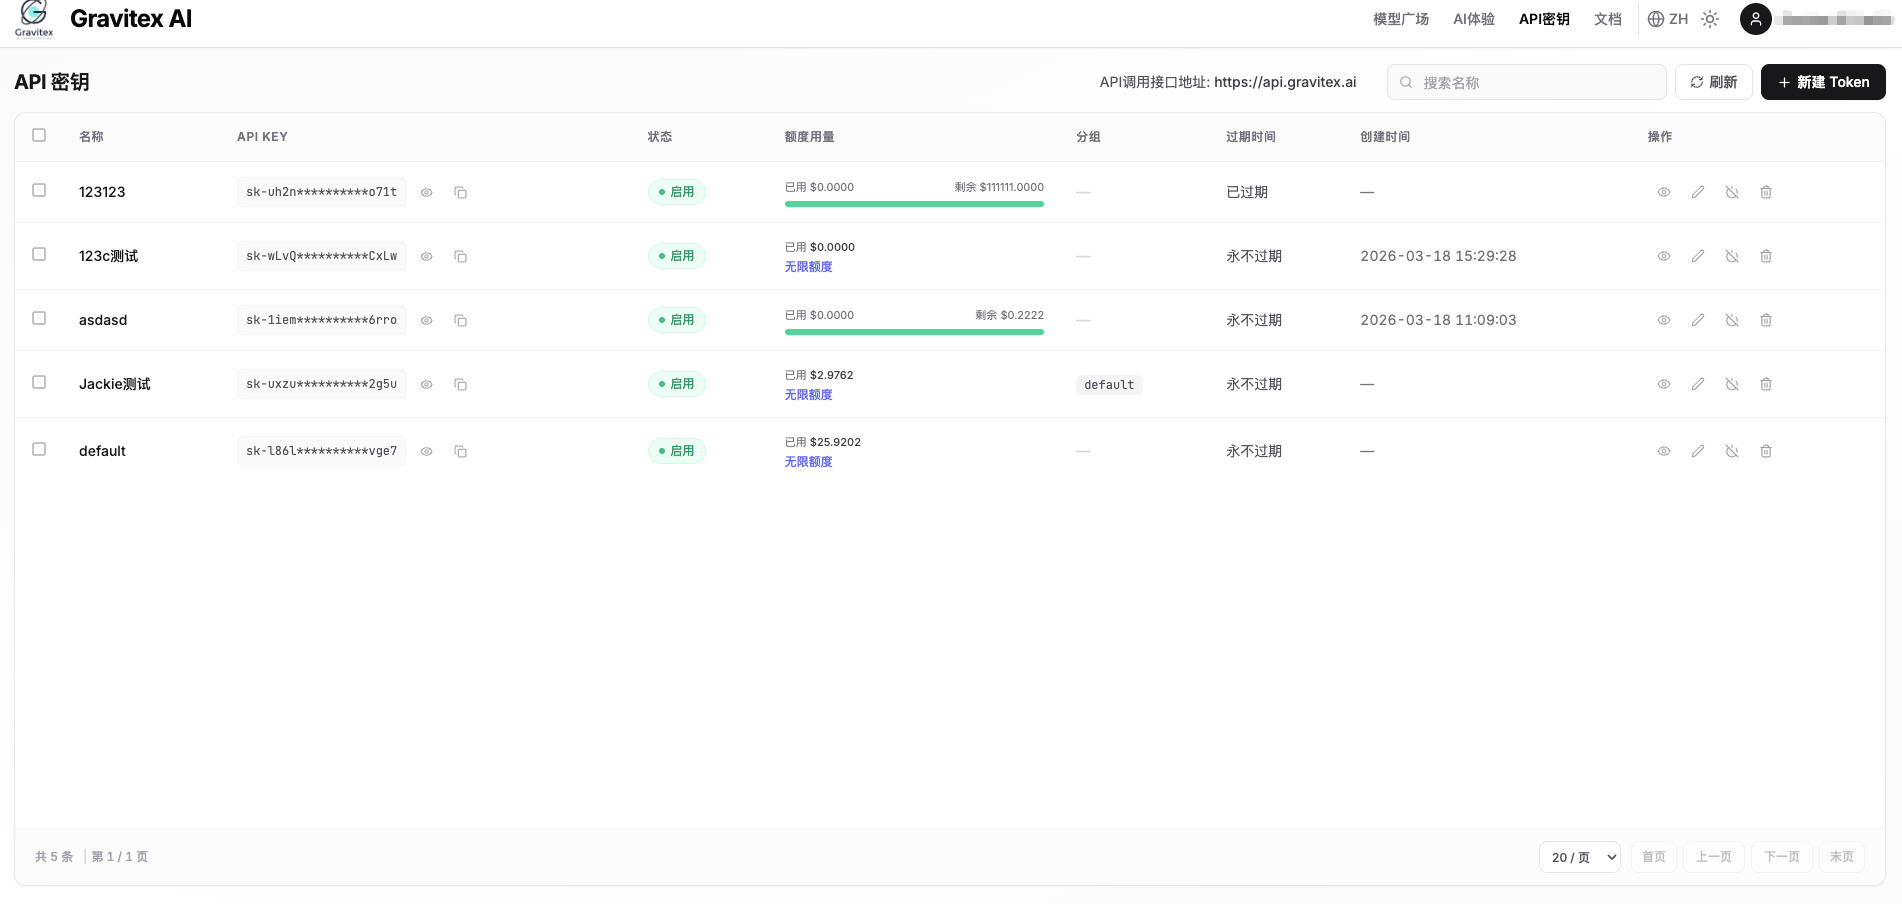
访问 NovaWander AI 控制台 创建一个 API Key:
2. 进入 Dify 模型供应商设置
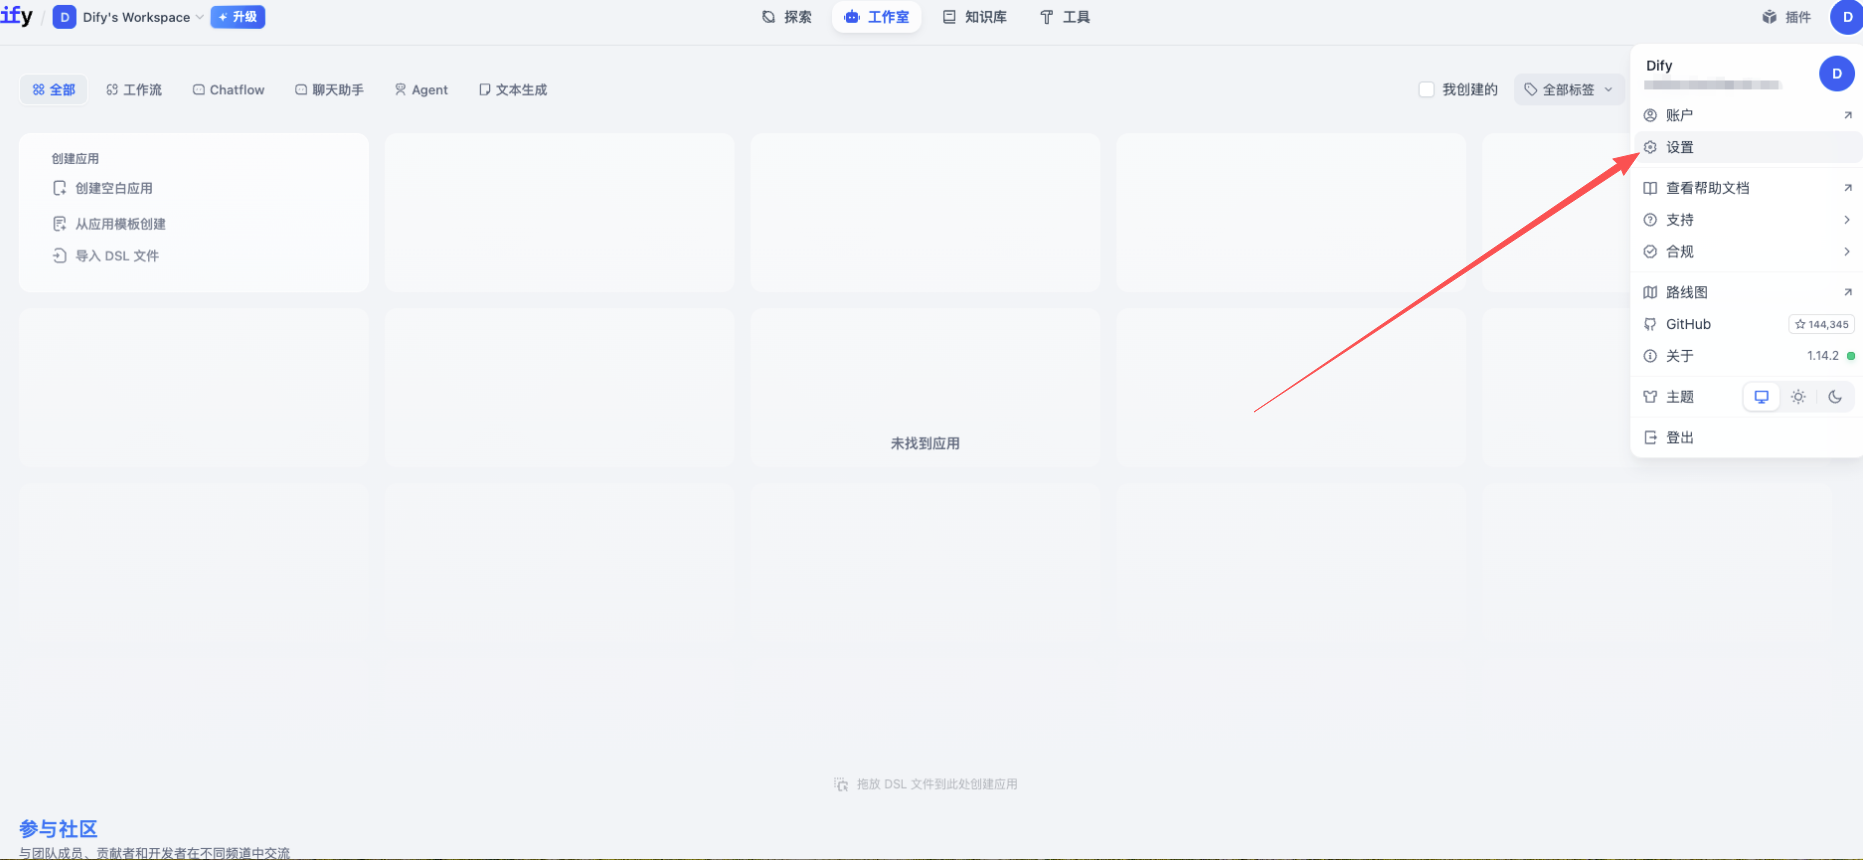
- 登录 Dify 平台,点击右上角用户名 → 设置
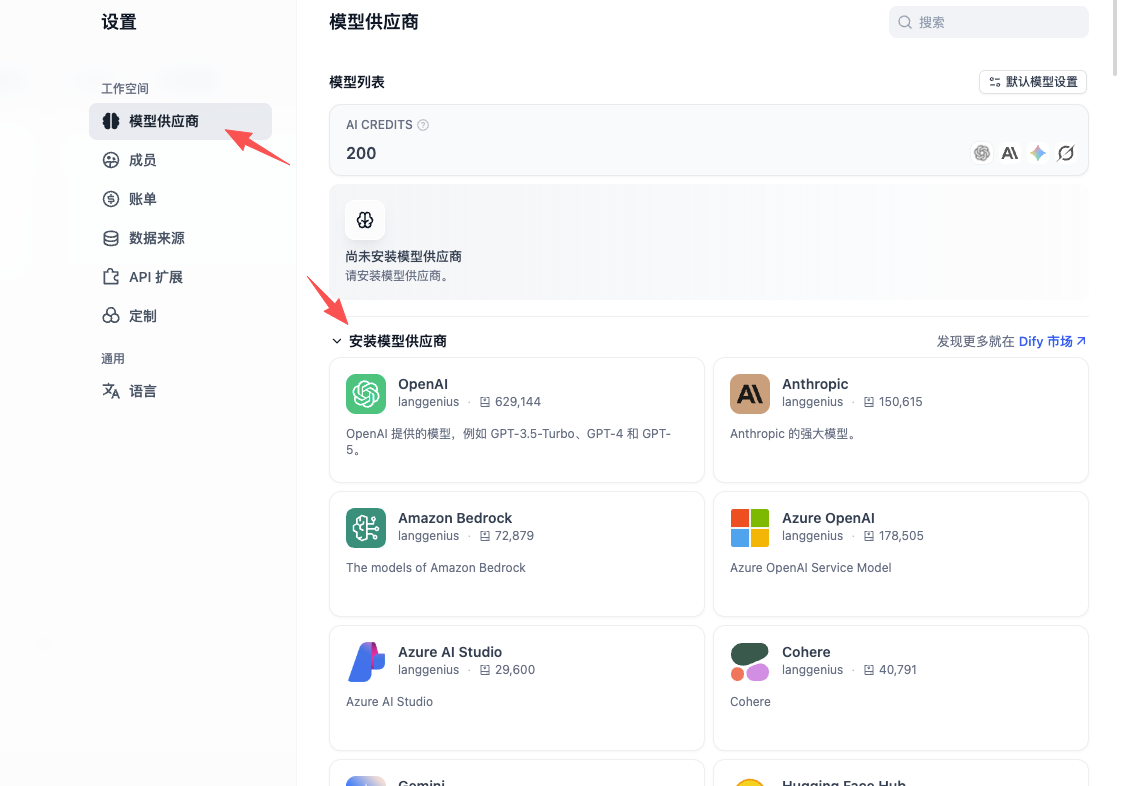
- 左侧菜单选择 模型供应商
- 在列表中找到 OpenAI-API-compatible 插件并点击安装
OpenAI-API-compatible 插件支持 Chat / Embedding / TTS / STT 等多种端点类型,NovaWander AI 全部兼容,一个插件即可覆盖所有模型。
3. 添加模型配置
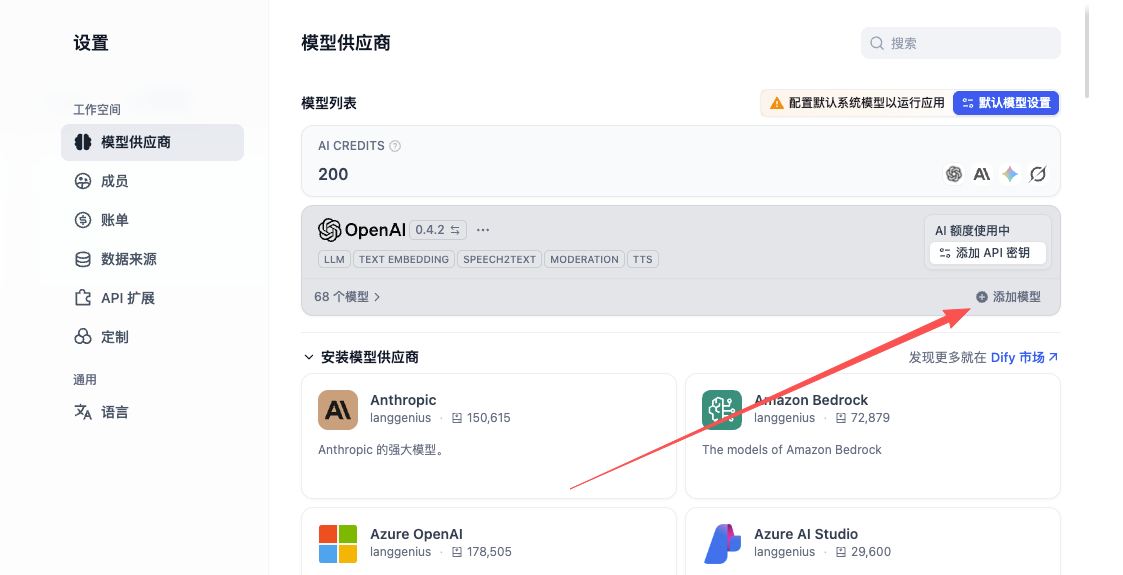
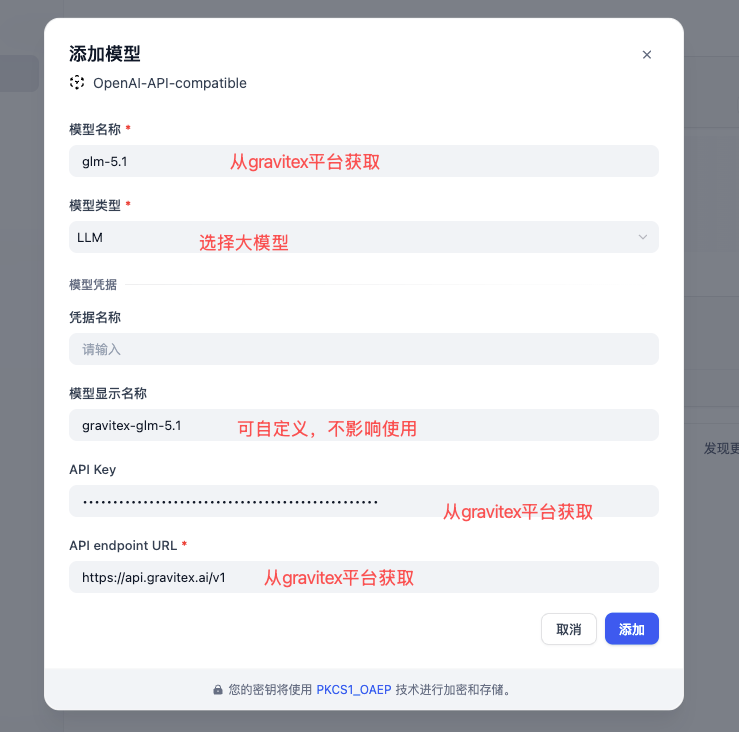
安装插件后,点击 增加模型,填入以下三个核心参数:
| 字段 | 填写内容 | 说明 |
|---|
| 模型类型 | LLM / Text Embedding / Speech2text 等 | 根据接入端点类型选择 |
| 模型名称 | 例如 gpt-5.5、claude-opus-4-7、gemini-3.5-flash | 必须填写 模型规范名,不能随意输入 |
| 模型显示名称 | 例如 GPT-5.5、Claude Opus 4.7 | 仅作显示,可自定义 |
| API Key | 从 NovaWander AI 控制台 复制 | 形如 sk-xxxxxxxx |
| API endpoint URL | https://api.novawander.cn/v1 | 注意末尾 /v1 不要漏 |
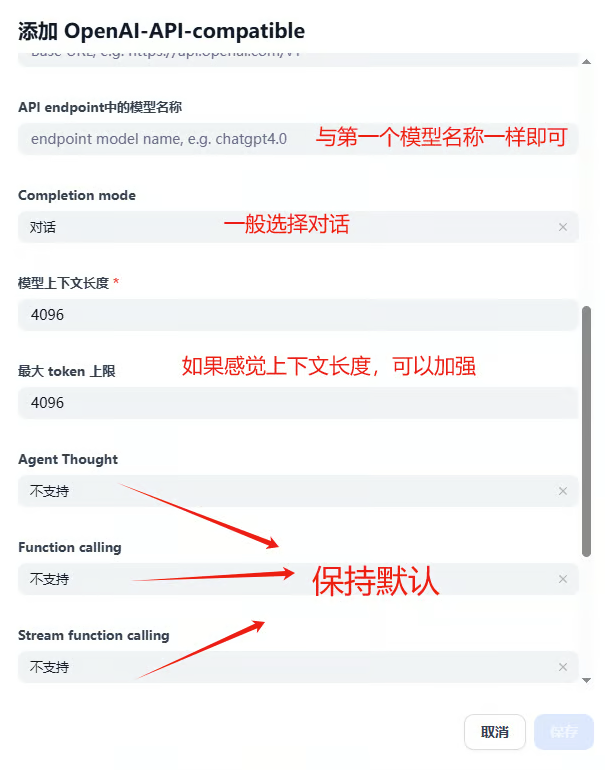
| API endpoint 中的模型名称 | 与”模型名称”完全一致 | Dify 会用此值作为请求 body 的 model 参数 |
“模型名称”和”API endpoint 中的模型名称”必须完全一致。错填(例如 Gemini 3.5 Flash 这种带空格的友好名)会导致 404 / model not found。
或者可以直接安装模型供应商,然后在添加 API 密钥时改为 NovaWander 的地址,可直接使用默认且在 NovaWander 平台有的模型。
4. 配置上下文长度与参数
Dify 默认 max_context = 4096,这对大多数现代模型来说远低于实际能力。请按实际模型设置:
| 模型 | 上下文长度 |
|---|
claude-opus-4-7 / gpt-5.5 / gemini-3.5-flash | 1,000,000 |
claude-sonnet-4-5 / claude-haiku-4-5 | 200,000 |
kimi-k2.5 | 256,000 |
deepseek-v3-2-251201 | 128,000 |
二、核心功能
1. 对话助手
最简单的应用类型,适合客服、知识问答、角色扮演等场景:
- 创建应用 → 选择 对话助手 模板
- 配置系统提示词:
你是 NovaWander AI 的智能客服助手,职责:
- 解答用户对接 API 时遇到的问题
- 推荐适合用户场景的模型
- 在不确定时引导用户查阅文档或联系 BD
保持友好、专业、简洁的语气。
- 模型选择
gpt-5.5 或 claude-opus-4-7
- 推荐参数:
temperature = 0.7,max_tokens = 2000
2. 工作流应用
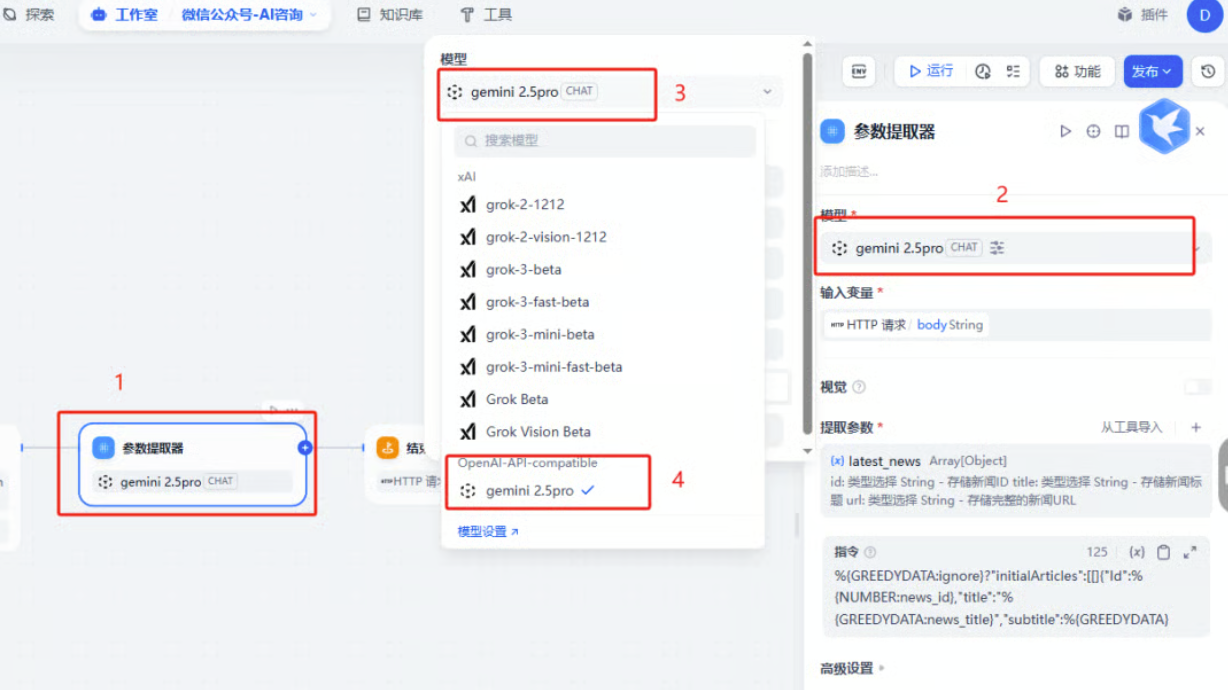
将多个步骤编排成 DAG,支持条件分支、并行、循环:
典型节点选型建议:
- 意图分类:
gemini-3.5-flash(高吞吐低延迟)
- 知识库检索 / 嵌入:
text-embedding-3-large 或 gemini-embedding-001
- 长文复盘 / 推理:
claude-opus-4-7(1M 上下文,强推理)
- 代码生成:
gpt-5.5 或 qwen3-coder-plus
3. 知识库问答(RAG)
- 创建知识库 → 上传文档(PDF / Word / Markdown / TXT 等)
- 选择嵌入模型:推荐
text-embedding-3-large(OpenAI)
- 分段策略:按段落自动分块,平均 500 token / 段
- 在应用中引用知识库
- 配置检索参数:
- Top-K: 3-5
- 相似度阈值: 0.7
- 重排序:开启(显著提升召回相关性)
三、应用类型与配置示例
应用类型: 对话助手
模型: gpt-5.5
系统提示: |
  你是专业的 AI 客服助手,负责:
  - 回答用户问题
  - 提供产品信息
  - 处理售后服务
  保持友好和专业的态度。
temperature: 0.7
max_tokens: 2000
应用类型: 工作流
输入: 上传文档
处理流程:
  1. 文档解析(Dify 内置 Parser)
  2. 长文摘要(claude-opus-4-7,1M context)
  3. 结构化要点提取
  4. 生成分析报告
输出: Markdown 报告
应用类型: 对话助手
模型: claude-opus-4-7
系统提示: |
  你是专业的编程助手,专长:
  - 代码编写与优化
  - 错误调试
  - 架构设计
  - 最佳实践建议
  请提供清晰、可运行的代码方案,并附简要解释。
temperature: 0.3
四、高级功能
1. 通过 API 调用 Dify 应用
Dify 应用本身可作为 HTTP 服务被外部调用。下面以一个对话助手为例:
import requests

url = "https://your-dify-instance/v1/chat-messages"
headers = {
    "Authorization": "Bearer YOUR_DIFY_APP_API_KEY",
    "Content-Type": "application/json"
}

payload = {
    "inputs": {},
    "query": "请用一句话介绍 NovaWander AI",
    "response_mode": "streaming",
    "user": "user_123"
}

resp = requests.post(url, headers=headers, json=payload, stream=True)
for line in resp.iter_lines():
    if line:
        print(line.decode("utf-8"))
2. 多模态(图片输入)
支持视觉理解的模型(gpt-5.5、claude-opus-4-7、gemini-3.5-flash)可以接收图片输入:
{
    "inputs": {
        "image": "data:image/jpeg;base64,...",
        "instruction": "分析这张图片中的关键信息"
    },
    "query": "请详细描述图片内容并给出业务建议"
}
3. 批量处理
针对大规模数据集(CSV 导入、文档批量摘要等),建议:
- 选用低成本快速模型(
gemini-3.5-flash、gpt 5.4 mini)
- 设置 Dify 工作流的并发上限,避免一次性打满速率
- 启用结果缓存,避免重复内容重复调用
五、模型选择策略
完整场景化模型推荐
查看 NovaWander AI 全场景模型推荐:文本创作、编程、快速响应、长文本、图像生成等。
成本优化:开发 vs 生产
开发环境:
  模型: gemini-3.5-flash      # 低成本,迭代快
  max_tokens: 1000
  temperature: 0.7

生产环境:
  模型: claude-opus-4-7        # 旗舰智能,稳定可靠
  max_tokens: 2000
  temperature: 0.3
  fallback: gpt-5.5            # NovaWander AI 自动故障转移
NovaWander AI 平台层面支持自动故障转移:某家供应商不可用时,平台会自动切到等价模型,无需在 Dify 侧做手动 fallback。
六、最佳实践
1. 结构化提示词
# 角色定义
你是一个专业的[具体角色]

# 任务说明
请帮助用户完成 [具体任务]

# 输出格式
1. 概述(<= 100 字)
2. 详细分析(分点列出)
3. 行动建议

# 约束条件
- 准确客观,有不确定时明确说明
- 控制在 500 字内
- 使用简体中文
2. 工作流设计
3. 监控与优化
定期审视:
- ✅ 用户满意度反馈(收集 thumbs up/down)
- ⏱️ P95 响应时间
- 💰 单次调用成本与日 / 月用量曲线
- ❌ 错误率与失败原因分布
NovaWander AI 控制台提供按 Key / 模型维度的实时用量与费用统计,可直接对账。
4. 版本管理
- 定期导出 Dify 应用配置(JSON / YAML)备份
- 测试新版本后再发布,使用灰度发布逐步切量
- 保留至少 N-1 版本以便快速回滚
七、故障排除
常见问题
模型调用 401 / invalid API key
- 检查 API Key 是否正确(从 控制台 重新复制)
- 确认账户余额充足
- 检查 baseURL 是否为
https://api.novawander.cn/v1(注意末尾 /v1)
404 / model not found
- 模型名称是否填写为 规范名(例如
gpt-5.5 而非 GPT-5.5)
- “模型名称”与”API endpoint 中的模型名称”是否完全一致
响应慢 / 流式输出卡顿
- 优先选择 Flash / Mini 级别的模型
- 减少
max_tokens 限制
- 启用 Dify 的结果缓存
性能优化参考
缓存设置:
  启用: true
  过期时间: 3600s
  缓存条件: 相同输入

并发控制:
  最大并发: 10
  队列大小: 100
  超时: 30s

资源限制:
  内存: 2GB
  CPU: 80%
八、部署建议
生产环境(自建 Dify)Docker Compose 示例
version: '3.8'
services:
  dify-api:
    image: langgenius/dify-api:latest
    environment:
      - SECRET_KEY=your-secret-key
      - DB_HOST=postgres
      - REDIS_HOST=redis
      - OPENAI_API_KEY=sk-your-novawander-key
      - OPENAI_API_BASE=https://api.novawander.cn/v1
    depends_on:
      - postgres
      - redis

  dify-web:
    image: langgenius/dify-web:latest
    ports:
      - "3000:3000"
    depends_on:
      - dify-api

  postgres:
    image: postgres:14
    environment:
      - POSTGRES_DB=dify
      - POSTGRES_USER=dify
      - POSTGRES_PASSWORD=password

  redis:
    image: redis:alpine
安全配置
- 把 API Key 存入环境变量或 Secret Manager,不要硬编码在 Dify 应用配置里
- 启用 HTTPS,前置反向代理(Nginx / Caddy / Traefik)
- 为 Dify 后台启用 SSO / 双因子认证
- 定期更新基础镜像与依赖
健康检查
import requests, time

def monitor_dify():
    try:
        r = requests.get("http://dify-api:5001/health", timeout=5)
        if r.status_code == 200:
            print("Dify 运行正常")
        else:
            print(f"异常,状态码: {r.status_code}")
    except Exception as e:
        print(f"监控失败: {e}")

while True:
    monitor_dify()
    time.sleep(60)
九、效果与对账
接入后回到 NovaWander AI 控制台,可以看到调用量、token 消耗、费用分布、按模型的成功率等指标:
- 模型名称必须使用 规范名(小写、与官方 model id 完全一致)
- API 地址统一:
https://api.novawander.cn/v1
- 建议先用
gemini-3.5-flash 等低成本模型在测试环境验证整个工作流,再切到 claude-opus-4-7 / gpt-5.5 等旗舰模型用于生产
- 大批量场景建议联系 bd@novawander.cn 申请专属配额